Lec 1: MapReduce
MapReduce 是一种批量计算模型:Map 将输入转换成键值对,框架把相同 key 的值分到一起,再交给 Reduce 计算结果。用户描述计算规则,框架负责把任务分配到多台机器,并在节点失败后重新执行。
本文是 2004 年论文与 MIT 课程的学习笔记。理解它的关键,是顺着一条数据看完分区、分组和输出,再判断重复执行为什么不会破坏结果,以及哪些性能问题不能靠增加机器解决。
1. 面试核心
先记住这几条,再读正文- Map 输出键值对序列,框架按 key 分组后调用 Reduce,同一个 key 的记录必须进入同一分区。卡 · MapReduce 编程模型
- 论文实现把 Map 中间结果保存在 Worker 本地,节点故障后,已完成的 Map 也可能需要重算。卡 · Worker 故障
- 当 Map 和 Reduce 都是确定性函数时,结合原子提交,重执行后的作业输出等价于顺序执行。卡 · Worker 故障
- Combiner 可以先做局部聚合,但必须保证无论怎样分组,最终答案都不变。卡 · Combiner
- 备份任务能缓解慢机器拖延作业的问题,却不能消除热点 key 带来的数据倾斜。卡 · 备份任务与数据倾斜
2. 论文介绍
Google 在 2004 年发表的 MapReduce 论文,面向离线索引、日志分析和大规模排序等任务。它把用户的计算函数与分布式执行分开:用户编写 Map、Reduce,运行时管理任务分配和失败恢复。
本文讲解的是论文中的实现。MIT 课程旧名为 6.824,现名为 6.5840;课程实验采用更简单的单机共享文件环境,需要与论文中的多机实现区分。
3. 分布式批处理问题
把大规模输入分片后,可以让多台机器并行处理,但分片只是第一步。机器可能在计算途中失败,有些任务也会比其他任务慢,框架还要负责重新调度和交换中间数据。
MapReduce 把这些工作从计算代码中分离出来。计算函数只描述一条输入怎样转换、一组中间数据怎样汇总,输入拆分、任务调度和数据交换都由运行时处理。
4. MapReduce 编程模型
4.1 Map 函数
Map 接收一个输入键值对,输出零个或多个中间键值对:
map(k1, v1) → list(k2, v2)
Map 不负责合并重复的 key。同一个 key 可以在一次或多次 Map 输出中出现,把这些值汇集起来是框架的职责。
4.2 Reduce 函数
Reduce 接收一个中间 key 及其对应的全部值,再生成零个或多个结果:
reduce(k2, list(v2)) → list(v2)
论文接口通过迭代器传入值序列。Reduce 可以逐步读取,不需要先把一个 key 的全部值放进内存。
4.3 单词计数
单词计数把每次出现的单词记为 1,再把同一个单词的所有 1 相加。下面用简化的 Python 函数表达这个过程:
def map_words(text):
    for word in text.split():
        yield word, 1

def reduce_word(word, values):
    return word, sum(values)
输入 apple pen apple 时,map_words 输出三个键值对:(apple, 1)、(pen, 1)、(apple, 1)。框架分组后,apple 对应 [1, 1],pen 对应 [1];reduce_word 分别求和,得到计数 2 和 1。
5. MapReduce 执行流程
一次作业会先执行多个 Map 任务,再由各个 Reduce 汇总自己的分区。Master 负责调度和记录文件位置,Worker 负责实际计算与数据读写:
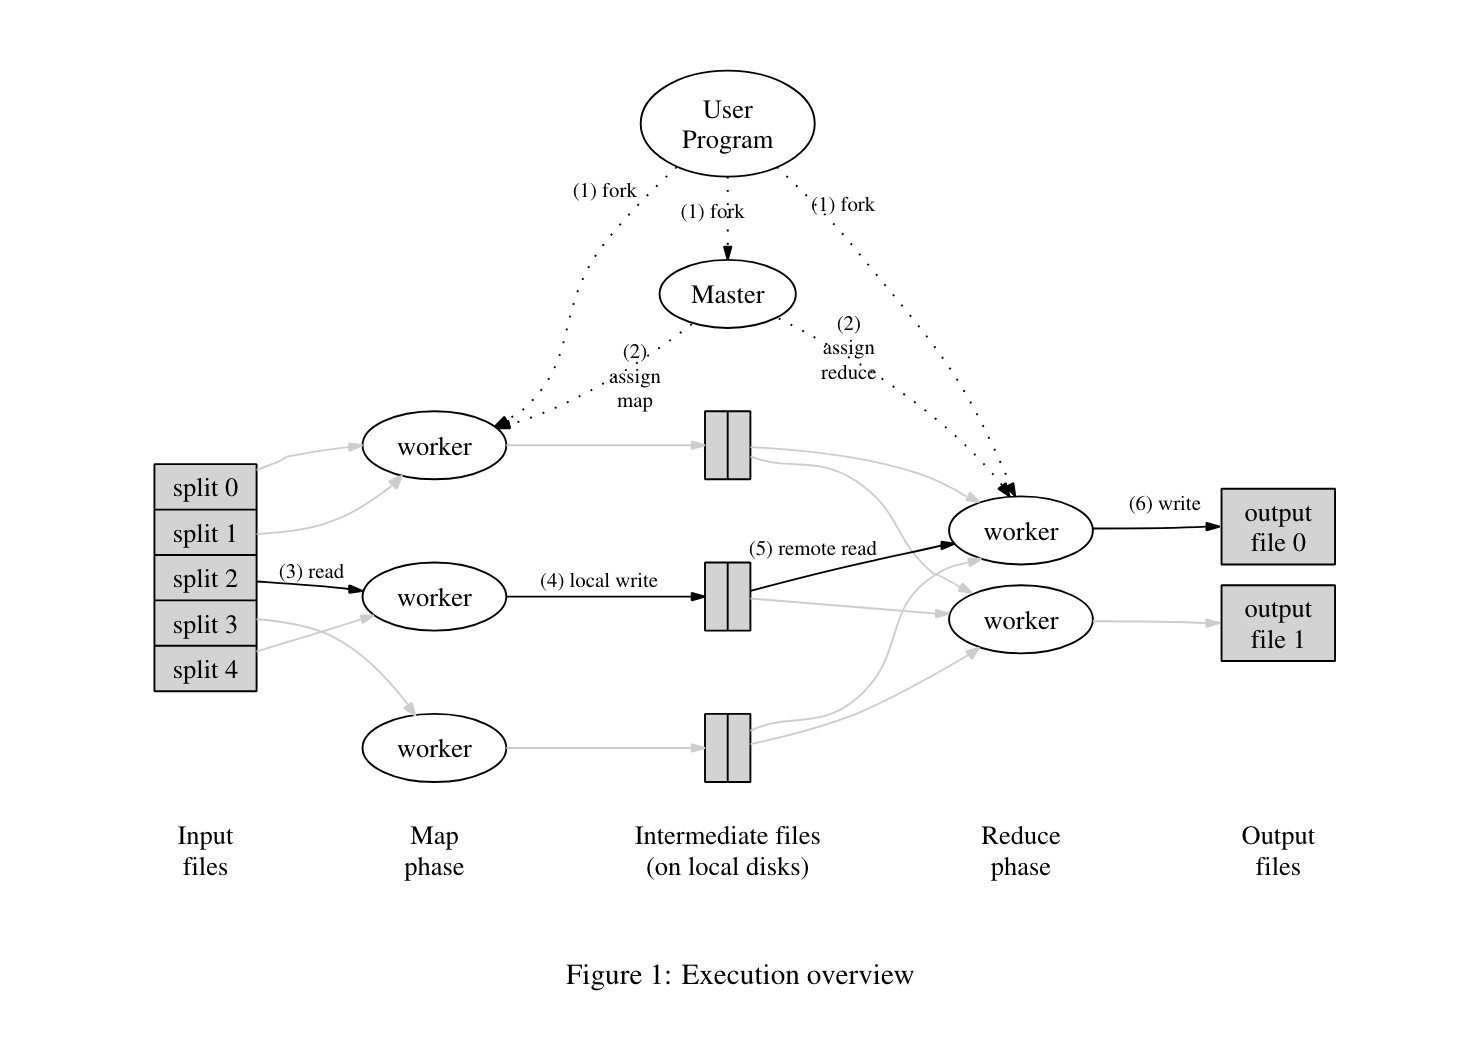
- 输入分为 M 个 Map 任务,用户设置 R 个 Reduce 分区。
- Master 将任务分配给空闲 Worker。
- Map 输出先写入内存缓冲,再按分区写入本地磁盘。
- Master 记录中间文件位置,并通知 Reduce Worker。
- Reduce Worker 拉取自身分区的数据,排序后按 key 分组。
- Reduce 写出结果文件,全部任务完成后结束作业。
5.1 Shuffle 与分区
Shuffle 是把 Map 输出重新组织成 Reduce 输入的过程,其中分区负责把同一个 key 的记录送到同一个 Reduce。默认分区函数可以用 hash(key) % R:同一个 key 算出的分区编号相同,因此不会被分到两个 Reduce 中分别计数。
每个 Reduce Worker 都要从各个 Map Worker 取得自己的分区,再在分区内排序、分组并调用用户函数。各个 Reduce 分区分别生成输出文件。
拉取数据可以与其他 Map 的执行重叠,但某个 key 的最终归约必须等输入完整。课程实验用更简单的 Map 完成屏障来保证这一点。M 与 R 则要按输入规模、并行度和输出需求选择,任务数多于机器数时,调度器可以在机器空闲后继续分配任务。
6. 容错
6.1 Master 故障
论文实现中的 Master 是单点,发生故障会中止作业,客户端可以选择重新执行。论文讨论过通过检查点恢复 Master 的方案,但该实现并没有提供这条恢复路径。
6.2 Worker 故障
Worker 故障后,是否需要重做任务,取决于输出还能不能读取。Master 通过探测判断 Worker 是否可达,并重新分配故障节点上尚未完成的任务。
这个节点已经完成的 Map 也要重做,因为中间文件在它的本地磁盘上,其他 Worker 无法再读取。已经完成的 Reduce 则不同:结果保存在全局文件系统中,执行它的 Worker 失效后,文件仍然可用。
6.3 输出提交与确定性
重执行要同时解决两件事:只采用完整的输出,以及重复计算得到什么结果。Map 完成后报告中间文件位置,Master 只接受一个有效完成结果,忽略重复报告。Reduce 则先写私有临时文件,再原子重命名到最终路径,因此最终文件来自某一次完整执行。
确定性函数是对相同输入产生相同结果的函数。当 Map 和 Reduce 都满足这一点时,采用哪次完整执行的结果都一样,作业输出就能与顺序执行等价。如果函数还会向外部系统写数据,这些副作用需要应用另外保证幂等。
非确定性 Map 的不同尝试可能生成不同结果,而不同 Reduce 分区又可能读取不同尝试的输出。这样,每个分区的结果可以分别对应某次顺序执行,整个作业却未必对应同一次顺序执行。
7. 性能优化
7.1 数据局部性与任务粒度
数据局部性是让计算尽量靠近数据所在的位置。调度器把 Map 放在输入所在机器附近,可以减少读取输入时的网络传输;中间结果保存在本地,也能减少额外复制流量。
任务拆得小一些,便于调度器把剩余工作交给空闲机器。但过细的任务会增加 Master 保存的元数据和调度次数,因此任务粒度要在并行度与管理成本之间取舍。
7.2 Combiner
Combiner 在 Map 端先做局部聚合,用来减少传输的中间记录。例如单词计数可以先把本机输出中同一个单词的多个 1 相加,再把局部计数发出去。
这种优化的前提是局部结果还能继续合并,且最终答案不变。满足结合律和交换律的聚合适合这样处理;即使框架没有执行 Combiner,结果也必须正确。
平均值不能直接这样合并。[1, 3] 和 [10] 的局部均值分别是 2 和 10,再平均会得到 6,但整体均值实际是 14/3。原因是两个局部均值包含的样本数不同。
可以让 Combiner 传递 (sum, count),最终分别加总,再用总和除以总数。样本数保留下来后,怎样分组都不会改变答案。
7.3 备份任务与数据倾斜
备份任务是在另一台机器上重复执行尚未完成的任务,并采用先完成的有效结果。它能缓解少数慢机器拖长整个作业的问题。
数据倾斜则是数据量分布不均,例如一个热点 key 集中了大量记录。把同一个任务换到另一台机器,仍然要处理这些数据,所以备份任务不能消除这种负担。
对于可以合并的聚合,可以先给热点 key 加不同后缀,把记录拆到多个分区,再用第二轮聚合合并结果。这种做法称为加盐拆键。如果操作必须一次看到同组的完整数据,就需要重新设计计算方式。
8. 使用边界
MapReduce 适合追求高吞吐的离线批处理。多轮计算需要反复写入中间结果,会增加 I/O 成本;交互查询和流式处理对响应方式的要求不同,需要采用相应的执行模型。
9. 面试题卡片
10. 参考资料
- Dean、Ghemawat:MapReduce,OSDI 2004
- MIT 6.824 / 6.5840:Lecture 1
- MIT 6.5840:2026 Schedule
- MIT 6.824 / 6.5840:Lab 1
- Apache Hadoop:MapReduce Tutorial
来源:Coding 101 原文 · 免费阅读,引用请保留出处。内容使用说明