实验 1: MapReduce
MapReduce 实验要实现一个能分配任务、执行计算,并在 Worker 失败后恢复的系统。正常路径并不复杂,难点在于:任务超时后可能被执行两次,系统怎样判断哪个结果有效,又怎样避免 Reduce 读到不完整的文件。
本文是 MIT 2026 年课程版本的实现笔记。课程旧名为 6.824,现名为 6.5840;实验要求与依赖版本以所选学期仓库为准。本文直接使用 Map、Reduce 和分区的概念,不熟悉计算模型时可先读 Lec 1: MapReduce。
1. 面试核心
先记住这几条,再读正文- Coordinator 管理任务状态,Worker 通过 RPC 领取任务并报告结果,两者的职责要分开。
- 本实验在 10 秒后重派未完成任务,但超时不代表原 Worker 已经停止,迟到的结果仍需校验。卡 · RPC 状态校验
- Reduce 要读取本分区来自全部 Map 的输出,因此实验中要等所有 Map 提交后再分配 Reduce。卡 · Coordinator
- 临时文件加原子重命名能避免读到半文件,但阻止旧任务覆盖新结果还需要校验执行版本。卡 · 输出提交
2. 实验简介
实验用 Go 实现一个 Coordinator 和多个 Worker,所有进程都运行在同一台机器上,并共享工作目录。这样可以把注意力集中在调度和失败恢复上,暂时不用处理跨机器文件传输与协调器复制。
实现既要完成正常的 Map、Reduce 计算,也要应对 Worker 崩溃。调试时尤其要观察重复执行和完成报告的顺序:第二次执行可能已经完成,第一次执行才报告成功。
3. 基本配置
先准备 Git 和课程要求的 Go 版本,再取得对应学期的实验仓库。仓库地址、启动命令和测试入口都以该学期实验页面为准。
Go 插件与主程序要使用相同工具链构建。更换 Go 版本后,两者都需要重新编译,否则可能在加载插件时失败。
4. 实验要求
实现分在三个文件中:
mr/coordinator.go管理任务和阶段。mr/worker.go执行任务并写出结果。mr/rpc.go定义通信字段。
保留 main/mrcoordinator.go 与 main/mrworker.go 的启动逻辑。Worker 不断领取任务、读取输入、执行计算并写出文件;Coordinator 将超过 10 秒还未完成的任务重新分配。
这里的超时是一条调度规则:Coordinator 决定不再等待,换一个 Worker 继续做。它无法据此证明原 Worker 已经停止,因此实现还要处理两个 Worker 同时完成同一任务的情况。
5. 任务细分
5.1 Coordinator
Coordinator 负责维护任务状态,状态可以分为 idle、running 和 completed。领取任务时,要在同一把锁内完成选择任务和改为 running 两步,否则两个 Worker 可能同时领走同一个空闲任务。计时也从这次分配开始。
阶段屏障是进入下一阶段前必须满足的条件:全部 Map 完成后才分配 Reduce,全部 Reduce 完成后 Done() 才返回 true。暂时没有任务可分配时,回复等待指令,让 Worker 稍后再来领取,避免持续空转。
完成数只在首次有效提交时增加。已接受的报告再次到达时,返回确认即可,不能重复计数。
5.2 Worker
Worker 负责计算和文件读写。执行 Map 时,先读取输入并调用用户函数,再按 ihash(key) % nReduce 将输出分区。中间文件约定为 mr-X-Y,其中 X 是 Map 任务编号,Y 是 Reduce 分区编号。
执行 Reduce 时,Worker 读取所有 Map 为本分区生成的文件,按 key 排序分组,再调用用户的 reduce 函数。最终结果写入 mr-out-Y。
输出先写入临时文件,成功关闭后再提交到正式路径,避免其他 Worker 读到只写了一半的内容。Go 1.17 起可用 os.CreateTemp 创建临时文件,具体提交方式见输出提交。
5.3 RPC
RPC 是进程之间的远程过程调用。这里可以定义 FetchTask 和 ReportTask:前者领取任务,后者报告完成。任务回复要包含任务类型、编号和输入位置;完成报告还要携带本次执行的版本号,后文称为 attempt。
Go RPC 编码的结构体字段需要导出,也就是字段名以大写字母开头。RPC 失败并不一定表示对端没收到请求,所以重发完成报告时,Coordinator 仍要能识别重复提交。
6. 实验实现
下面保留设计片段,完整实现由读者自行完成。attempt 是区分重复执行的可选加强方案,不是另一个任务编号。
6.1 任务结构
attempt 是同一任务的一次执行版本。每次重新分配任务时递增它,Coordinator 就能区分当前执行和超时后迟到的旧执行:
type Task struct {
    TaskType   string
    TaskID     int
    Inputs     []string
    Outputs    []string
    Status     string
    Attempt    uint64
    AssignedAt time.Time
}

type Coordinator struct {
    mu           sync.Mutex
    tasks        []Task
    nReduce      int
    nMap         int
    finishedMaps int
}
这段结构定义需要导入 sync 与 time。AssignedAt 记录本次分配的时间,重派时与 Attempt 一起更新。任务编号不变,但执行版本已经不同。
6.2 Worker 与 Coordinator 的交互
任务从领取到完成,需要经过计算、报告和提交三个步骤。Worker 完成计算,不代表 Coordinator 已经接受结果:
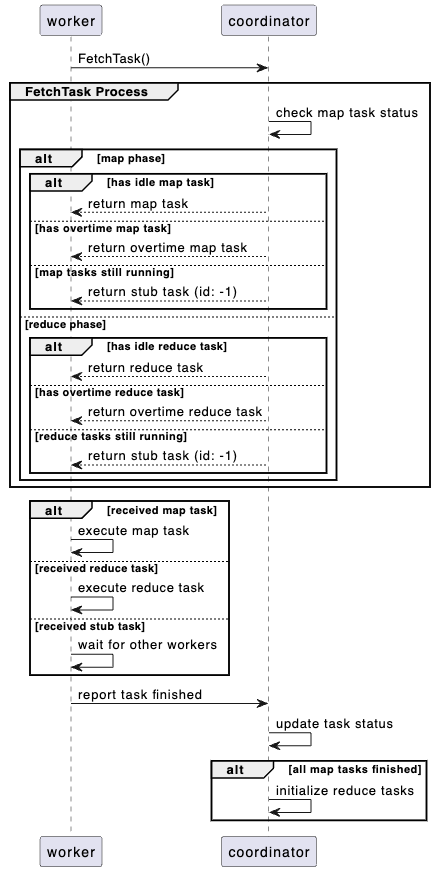
- Worker 通过
FetchTask获取任务或等待指令。 - Coordinator 在锁内将任务标记为
running,并返回 attempt。 - Worker 执行任务,写完本次执行的临时输出。
- Worker 报告任务编号、attempt 和文件位置。
- Coordinator 校验报告并提交输出,随后更新阶段。
Coordinator 的锁用于保护任务状态,不能一直持有到 Worker 完成计算,否则其他 Worker 在此期间无法领取任务。
6.3 RPC 状态校验
Coordinator 只接受当前执行版本的结果。假设 attempt 1 超时后,任务被重派为 attempt 2;旧 Worker 随后报告成功,Coordinator 就要拒绝 attempt 1。
校验要同时检查任务类型、编号、状态与 attempt。当前版本已经完成时,重复报告只返回确认;版本不匹配时,既不改任务状态,也不增加完成数。这样,重复报告和旧版本报告就不会推动错误的阶段转换。
6.4 输出提交
原子重命名保证一次替换后看到的是完整文件,却不能判断文件来自哪个 attempt。旧 Worker 即使写出了完整文件,也可能覆盖更新的结果。
一种做法是让 Worker 只写 attempt 专属文件,由 Coordinator 验证版本后,在提交临界区把它们放到最终路径。Worker 自己不直接覆盖最终文件,版本校验才真正约束得住输出。
一个 Map 会产生多个分区文件,可以逐个提交,全部成功后才标记任务完成。前面的阶段屏障保证 Reduce 在此之前不会读取这些文件。这个方案依赖本实验中 Coordinator 持续运行的假设,没有解决它在提交中途崩溃后的恢复。
临时文件与目标文件要放在同一文件系统。实验使用 Unix 环境下 rename 的原子替换语义,跨文件系统移动不能沿用这一保证。
7. 测试
2026 年实验在仓库的 src 目录运行 make mr。除了最终输出,还要观察失败恢复是否符合预期:
- 正常 Map 与 Reduce 的输出应与顺序程序一致。
- 并行领取任务后,同一任务只接受一次有效完成。
- Worker 崩溃后,任务应在超时后恢复。
- 旧 attempt 迟到时,当前结果保持不变。
- Map 输出提交失败时,Reduce 阶段继续等待。
共享状态竞争可用 Go 的 race detector 检查。启用时,插件和主程序要使用一致的构建选项。本文所在仓库没有包含实验实现,这些是实现完成后需要执行的验证步骤。
8. 面试题卡片
9. 参考资料
- MIT 6.824 / 6.5840:Lab 1 MapReduce
- MIT 6.5840:2026 Schedule
- Dean、Ghemawat:MapReduce,OSDI 2004
- Go:os.Rename
- Go:plugin
- Go:Data Race Detector
来源:Coding 101 原文 · 免费阅读,引用请保留出处。内容使用说明